Devops
Secretos en k8s II – Más allá de SealedSecrets con Azure Key Vault
En el capítulo anterior explicamos cómo dejamos de guardar secretos en texto plano en nuestros repositorios de GitHub y empezamos a usar SealedSecrets. Ese cambio resolvió el problema más urgente que teníamos: los valores reales ya no estaban a la vista de cualquiera con acceso de lectura al código. Durante un tiempo, fue suficiente.
Pero cuando una solución se usa todos los días, por equipos distintos y en clústeres distintos, empiezan a aparecer los pequeños problemas. En nuestro caso, todos surgían en el mismo momento: cuando había que crear, renovar o rotar un secreto. El cliente kubeseal no funcionaba bien en Windows y tenía conflictos con nuestros controles de seguridad. El acceso a los clústeres estaba restringido a la red interna de la empresa, así que solo unas pocas personas podían sellar un valor nuevo, y algunas tenían que usar herramientas ad hoc que se ejecutaban dentro del clúster para hacerlo. Y los bots de revisión de código seguían marcando los valores sellados como secretos expuestos, aunque estuvieran cifrados. Ninguno de estos problemas era un fallo de seguridad por sí mismo, pero juntos convertían un simple cambio de contraseña en un pequeño proyecto.
Al final del primer capítulo dejamos por escrito lo que esperábamos de la siguiente solución. Queríamos gestionar los secretos desde un lugar central, con herramientas que no dependieran de un sistema operativo concreto. Solo las personas con más privilegios debían poder gestionarlos. La creación y la rotación de secretos en producción debían automatizarse todo lo posible. Y los repositorios no debían contener secretos, ni siquiera cifrados.
Este artículo trata de las discusiones que tuvimos después. Todavía no habla de herramientas. Habla de cómo decidimos enfocar el problema y de un detalle que al principio subestimamos: las credenciales necesarias para leer los secretos.
Cambiar la pregunta
Con SealedSecrets, la pregunta que habíamos respondido era «¿cómo podemos guardar secretos en Git de forma segura?». Cuando empezamos a analizar los nuevos requisitos, nos dimos cuenta de que el último lo cambiaba todo. Si los repositorios no debían contener secretos, ni siquiera cifrados, la pregunta era otra: ¿cómo podemos mantener los secretos fuera de Git y que, aun así, estén en los clústeres cuando las aplicaciones los necesiten?
No era un cambio menor para nosotros. Nuestro equipo de DevOps trabaja siguiendo GitOps, y ArgoCD usa la información de los repositorios como única fuente de verdad de lo que está desplegado. Como explicamos en el primer capítulo, esta era una de las razones por las que no podíamos crear sin más los secretos a mano en los clústeres. Cualquier cosa creada fuera de Git podía verse en ArgoCD como desincronizada y podía perderse.
La solución fue separar dos cosas que hasta entonces siempre habían ido juntas: la definición de un secreto y su valor. Git puede seguir describiendo qué secreto necesita una aplicación, en qué namespace debe existir y qué componente lo va a usar. Eso es configuración, y no hay ningún problema en tenerla en un repositorio, revisada y versionada como el resto del código. Lo que Git no necesita saber es la contraseña en sí.
Así que tendríamos dos fuentes de verdad en lugar de una. Git para el estado deseado de la infraestructura y las aplicaciones, y un almacén de secretos externo para los valores sensibles. Puede parecer una contradicción con GitOps, pero en la práctica no lo es. ArgoCD sigue desplegando exactamente lo que está definido en el repositorio, y el repositorio sigue describiendo el despliegue completo. Solo que apunta al valor en lugar de contenerlo.
Había otra ventaja de la que hablamos mucho en el equipo. Con este modelo, la persona que despliega una aplicación no necesita conocer la contraseña de la base de datos, y la persona que rota esa contraseña no necesita tocar un chart de Helm. Cada vez que un secreto se copia, se pega en un fichero o se escribe en una terminal, aparece una nueva oportunidad de cometer un error o de exponerlo sin querer. Reducir esos momentos era, para nosotros, tan importante como el propio cifrado.
Un almacén central: Azure Key Vault
Una vez que acordamos que los valores debían vivir fuera de Git, la siguiente pregunta era dónde. La respuesta fue bastante sencilla. Nuestra plataforma funciona en Azure, todas nuestras aplicaciones se despliegan en clústeres de AKS y Azure Key Vault ya estaba disponible dentro de la empresa. Después de varias discusiones en el equipo, decidimos usarlo como almacén central para todos nuestros secretos.
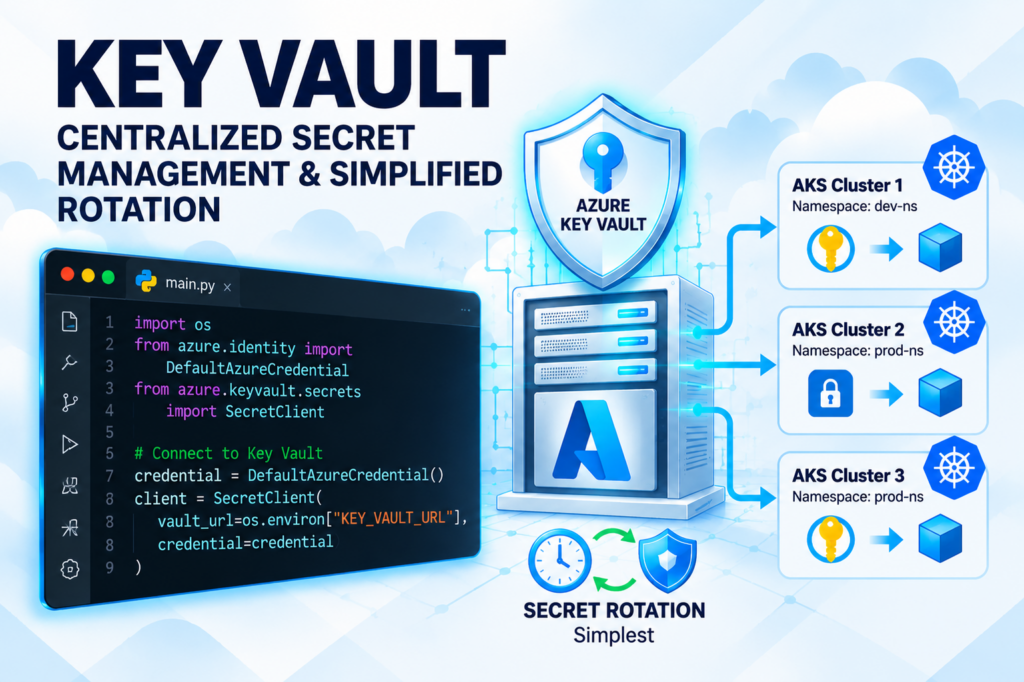
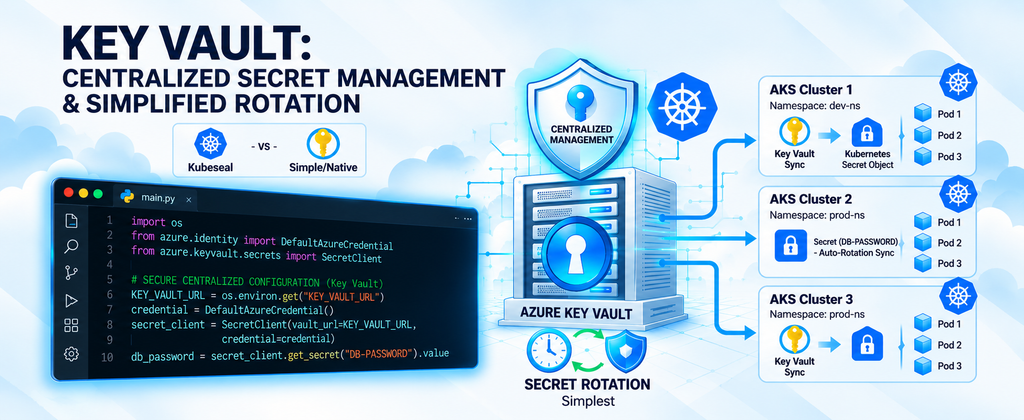
Key Vault nos daba lo que SealedSecrets no podía darnos. El acceso se controla desde Azure, con el mismo modelo de identidades y permisos que ya usamos para el resto de la infraestructura, así que podemos decidir exactamente quién puede leer o modificar cada secreto. No necesita ningún cliente instalado en el portátil del usuario, con lo que desaparecen los problemas con Windows. Y la rotación se vuelve mucho más sencilla, al menos en teoría: el valor se cambia en un solo sitio, en lugar de generar un nuevo valor sellado para cada clúster y subirlo a varios repositorios.
Ese «en teoría» es importante. Tener los secretos en Key Vault resuelve dónde se guardan. No resuelve cómo llegan a los pods.
¿Cómo llegan los valores a los clústeres?
Esta fue la parte más larga de nuestras discusiones. Antes de mirar herramientas concretas, intentamos entender qué preguntas tenía que responder la solución, porque con SealedSecrets ya habíamos aprendido que una herramienta que al principio parece buena puede generar mucho trabajo después.
La primera pregunta era quién lleva el valor al clúster. Una opción es que el valor se inyecte desde fuera, durante el despliegue, en el mismo proceso que aplica los manifiestos. La otra es que algo que se ejecuta dentro del clúster lea el valor de Key Vault y lo cree localmente. La primera es sencilla y encaja bien con GitOps, pero hace que la gestión de secretos dependa de la herramienta de despliegue. La segunda es más independiente, pero implica que cada clúster tiene que poder hablar con Key Vault por su cuenta.
La segunda pregunta era cómo consumen el valor las aplicaciones. La mayoría de nuestras aplicaciones, y sobre todo los productos de terceros como Redis, MongoDB, PostgreSQL o Superset, se despliegan con charts de Helm que esperan un Secret estándar de Kubernetes. Una solución que entregue los secretos de otra forma, por ejemplo como ficheros montados en un volumen, podía obligarnos a modificar esos charts, y eso era algo que queríamos evitar porque complica las actualizaciones futuras.
La tercera pregunta era qué pasa después de una rotación. Actualizar un valor en Key Vault es fácil. Actualizar el Secret de Kubernetes también es posible. Pero muchas aplicaciones leen su configuración solo cuando arranca el contenedor, así que un pod que ya está en marcha sigue usando la contraseña antigua. Si la solución no tenía esto en cuenta, cada rotación seguiría necesitando un reinicio manual.
La última pregunta era la escala. No hablamos de una aplicación en un clúster. Tenemos varios clústeres de AKS, cada uno con muchos namespaces y muchas aplicaciones. Cualquier paso que haya que repetir a mano en cada namespace o en cada clúster es un paso que, en algún momento, se olvidará.
Estas cuatro preguntas se convirtieron en nuestros criterios para evaluar cualquier herramienta.
El secreto detrás de los secretos
Quedaba una pregunta más, y tardamos un tiempo en ver lo importante que era.
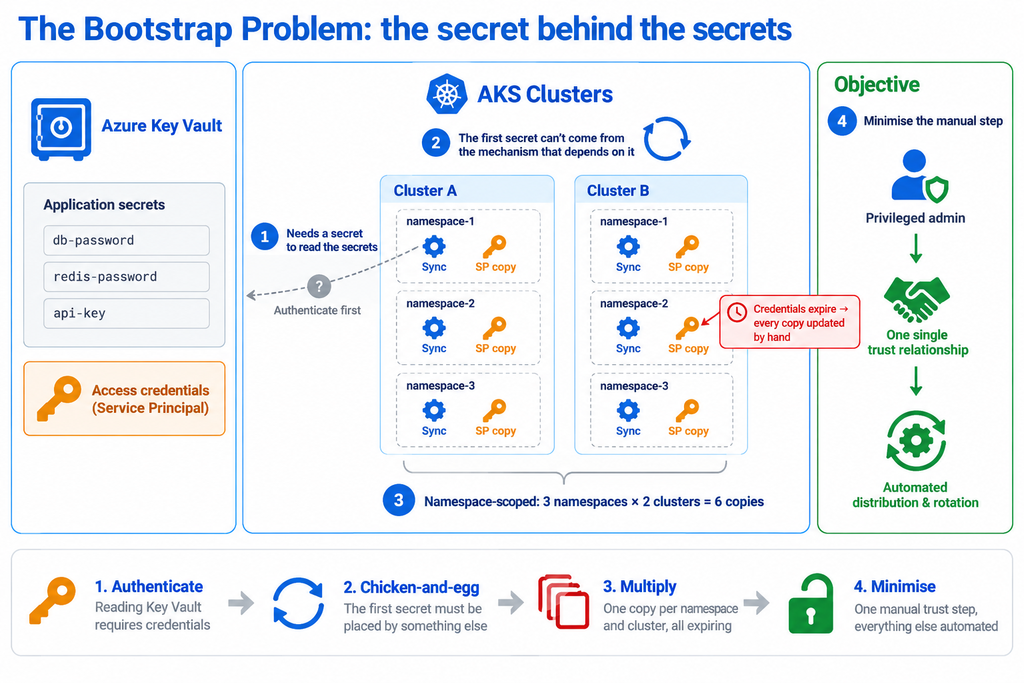
Para leer un secreto de Azure Key Vault, cualquier componente necesita autenticarse primero. En nuestro caso, eso significa credenciales, por ejemplo un Service Principal con permisos sobre el almacén. Y esas credenciales son, por supuesto, también un secreto. Así que, antes de que el clúster pueda obtener los secretos, necesita un secreto para obtener los secretos. Empezamos a llamarlo el problema del bootstrap.
El primer secreto no se puede obtener con el mecanismo que depende de él. Si una herramienta sincroniza secretos desde Key Vault, no puede crear sus propias credenciales para acceder a Key Vault, porque las necesita antes de poder hacer nada. Algo distinto tiene que ponerlas ahí.
En un solo clúster esto parece un detalle menor. Un administrador crea las credenciales a mano una vez y, a partir de ese momento, la sincronización se encarga del resto. Pero los Secrets de Kubernetes están limitados a su namespace: un secreto creado en un namespace no se puede referenciar desde otro. Así que, si las credenciales se necesitan en diez namespaces, tienen que existir diez veces. Con varios clústeres, el número vuelve a multiplicarse.
Y luego las credenciales caducan, o hay que rotarlas por las políticas de seguridad. Cada copia debe actualizarse, en cada namespace y en cada clúster, a mano. Es exactamente el tipo de trabajo que queríamos eliminar al dejar SealedSecrets, solo que ahora escondido en un lugar donde es fácil olvidarlo. Un almacén de secretos centralizado debería reducir la duplicación, no crear un nuevo conjunto de copias que nadie gestiona.
Por tanto, el problema del bootstrap no consiste solo en arrancar el sistema la primera vez. Se trata del ciclo de vida completo de las credenciales que hacen posible todo el sistema. También aceptamos que no se puede eliminar del todo. En algún momento tiene que existir una primera relación de confianza, creada por una persona con privilegios. Nuestro objetivo era reducir ese paso manual al mínimo, idealmente a un único momento, y gestionar todo lo demás de forma automática.
Lo que estábamos buscando
Al final de este análisis teníamos una imagen mucho más clara de la arquitectura que queríamos, incluso antes de elegir ninguna herramienta.
Git definiría las aplicaciones y qué secretos necesita cada una, pero nunca los valores. Azure Key Vault guardaría toda la información sensible, incluidas las credenciales necesarias para acceder a él. Un mecanismo de bootstrap colocaría esas credenciales en los clústeres y las mantendría actualizadas. Un mecanismo de sincronización leería los secretos de las aplicaciones desde Key Vault y crearía Secrets estándar de Kubernetes en los namespaces adecuados. Y algo se encargaría de que las aplicaciones en marcha empezaran a usar un valor nuevo después de una rotación, sin que nadie tuviera que reiniciarlas a mano.
Lo que todavía no teníamos eran las herramientas. Y en una empresa como la nuestra, la elección no es totalmente libre. Las políticas de seguridad, el soporte y la experiencia de otros equipos influyen mucho, y además había cierta urgencia por tener una solución pronto, así que no queríamos construir nada desde cero. Dentro de la organización había tres opciones ya aprobadas y funcionando en otros proyectos: ArgoCD Vault Plugin, Secrets Store CSI Driver y External Secrets Operator.
En el próximo capítulo explicaremos cómo encajaba, o no, cada una de ellas en esta imagen, y la combinación que finalmente pusimos en producción.
Versión en inglés publicada en el Blog de Xebia