Devops
Secretos en k8s I – De secretos en plano a SealedSecrets
Contexto
La situación que se describe en este post tiene su origen en un proyecto en un cliente de la industria farmacéutica: muchos equipos de trabajo (varios miles), que operan en remoto desde distintas partes del planeta y que en muchos casos no disponen de personal técnico, sino que sus componentes son investigadores de diversas materias relacionadas que se han tenido que adaptar a trabajar con herramientas de software avanzadas, tales como máquinas virtuales, bases de datos para gestión de grandes cantidades de información, repositorios de código, contenedores o clusters de kubernetes.
Estos equipos se dedican en la mayor parte de los casos a investigación de productos propios de la empresa, o a crear herramientas que dan apoyo a los primeros. Esto hace que en muchos casos, la información que se maneja sea extremadamente sensible, ya que se trata de datos privilegiados, cuyo mal uso puede derivar en errores de cálculo, resultados inexactos, pérdida de información altamente privada, espionaje, etc.
1. El problema: secretos en el código
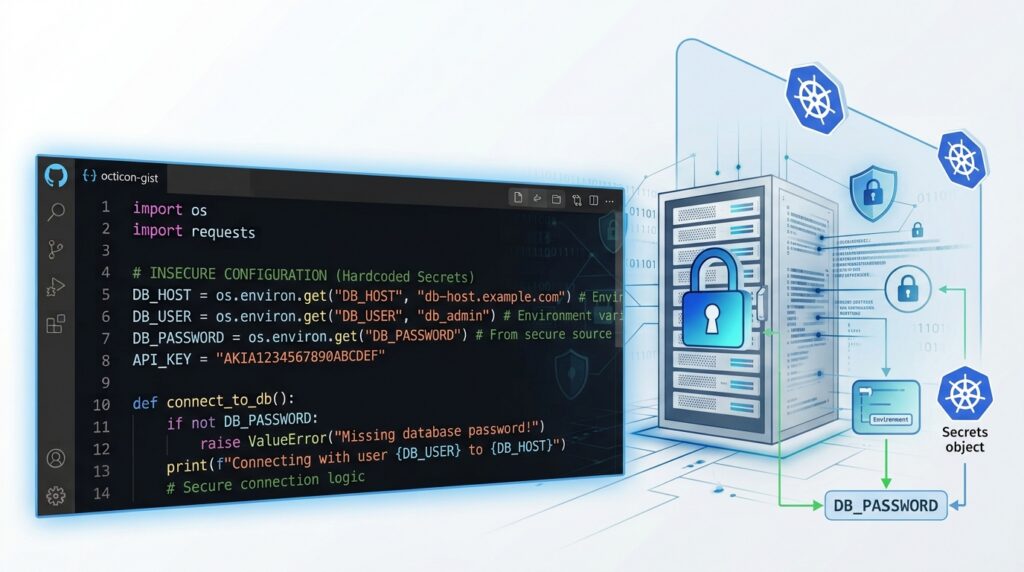
El problema que describimos aquí es muy habitual en empresas que llevan mucho tiempo usando repositorios para gestionar su código: llega un momento en el que necesitan manejar información sensible, como contraseñas, tokens de acceso, claves privadas, etc. El verdadero problema es dónde guardar esa información de forma segura.
En nuestro caso, las primeras fases del proyecto se desarrollaron en un momento en el que no existían requisitos corporativos sobre cómo tratar este tipo de datos. A eso se sumaba que usábamos una versión de GitHub Enterprise Server alojada en nuestros propios servidores. Como resultado, cada equipo guardaba estos secretos directamente en sus repositorios de GitHub, donde cualquier persona con permisos de lectura podía verlos.
A medida que crecía el número de repositorios, y con él el número de personas con acceso, aquello se convirtió en un problema de seguridad real, porque no podíamos controlar quién veía una información tan sensible. Y no hay que olvidar que, además, se trata de un área de investigación, por lo que la información expuesta suponía un riesgo desde el punto de vista corporativo.
A todo esto se añadía un «inconveniente»: el equipo de ingeniería DevOps había adoptado la filosofía GitOps, en la que la información de los repositorios y de las herramientas externas es la única fuente de verdad sobre las aplicaciones desplegadas. Como nuestra plataforma de despliegue está formada por clústeres de Azure AKS, crear secretos directamente en los clústeres no era la mejor opción siempre que hubiera una alternativa, porque podía provocar pérdidas de datos si herramientas como ArgoCD interpretaban los componentes creados a mano como desincronizados respecto a esa única fuente de verdad.
Teníamos dos problemas que resolver:
- Queríamos que nuestros secretos estuvieran guardados en algún lugar fuera de los clústeres y que sus valores se sincronizaran de alguna forma con el entorno de producción.
- Los valores de los secretos no podían estar al alcance de cualquiera que tuviera acceso de lectura a los repositorios de código; verlos y modificarlos debía quedar restringido a un grupo reducido de personas con permisos más altos.
2. Primera solución: Sealed Secrets
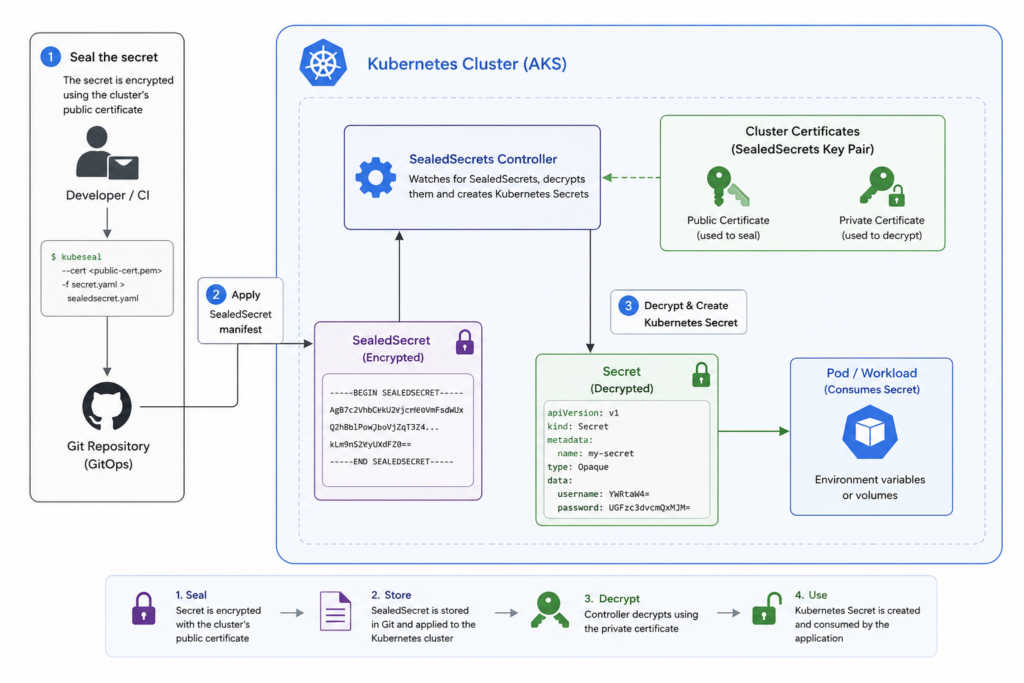
La opción elegida fue utilizar SealedSecrets Operator. SealedSecrets es una herramienta diseñada para ofuscar secretos de tal forma que solo puedan descifrarse en el destino en el que se sellaron. A modo de ejemplo, la herramienta se instala en un clúster de Kubernetes. Mediante un cliente (kubeseal), podemos generar el valor ofuscado de un secreto determinado específicamente para ese clúster, e incluso para un espacio de nombres concreto.
A partir de ese momento, este valor sellado puede almacenarse tal cual en cualquier repositorio, ya que el valor en sí mismo no proporciona ninguna información significativa a terceros. Solo cuando ese SealedSecret se implemente en el clúster de Kubernetes de destino, la herramienta lo descifrará de nuevo y creará un secreto normal que pueda ser utilizado por una aplicación que se ejecute en un pod.
3. ¿Cómo se sincronizan los secretos ahora?
El proceso para crear un secreto en el clúster pasa a ser el siguiente:
- Un usuario con privilegios de acceso al clúster usa kubeseal, desde cualquier equipo en el que pueda ejecutarse este cliente, para cifrar el valor de un secreto. Este secreto cifrado solo puede descifrarlo la herramienta instalada en el clúster de AKS.
- El valor cifrado se guarda en un fichero dentro del repositorio de GitHub. Ese valor, directamente en un manifiesto o a través de una herramienta de despliegue como Helm, se usa para crear un objeto SealedSecret en el clúster de AKS.
- El controlador de la herramienta detecta el SealedSecret en el clúster y, con sus propios certificados, lo descifra para crear un objeto Secret de Kubernetes.
- El valor queda disponible para los pods de la aplicación, que lo usarán en las configuraciones que lo necesiten.
Con esto resolvimos los dos problemas que teníamos:
- Podemos mantener nuestra configuración en Git sin exponer los valores reales de los secretos, y la información se sincroniza con el clúster mediante un proceso automático.
- Solo las personas con privilegios pueden usar kubeseal conectado al clúster de AKS para sellar valores que se descifrarán una vez desplegados.
4. Y Ahora Tenemos Otros Problemas
Lo que al principio supuso una gran ayuda acabó provocando otros problemas más adelante, todos ellos relacionados principalmente con la renovación y la rotación de secretos:
- El cliente Kubeseal no funciona bien en Windows y entraba en grave conflicto con nuestros controles de seguridad. Esto, unido a la necesidad de tener acceso directo al clúster, creó un claro cuello de botella a la hora de rotar o renovar secretos, ya que solo el personal con privilegios elevados podía realizar los cambios.
- Cuando el acceso a los clústeres se restringió aún más para que solo fuera posible desde la red interna de la empresa, el número de personas que podían actualizar los secretos se redujo aún más. En algunos casos, incluso se crearon herramientas ad hoc para generar los valores sellados a partir de pods montados dentro del propio clúster, pero el acceso seguía siendo costoso y muy restringido.
- Los bots de revisión de código señalaban con frecuencia los SealedSecrets como secretos expuestos en los repositorios de GitHub, lo que entraba en conflicto con las políticas de seguridad existentes.
- En muchos casos, el mismo secreto está distribuido por multitud de namespaces, ya que lo usan las distintas aplicaciones (por ejemplo, unas credenciales para el registry de docker). Cuando hay que rotar un secreto, implica tener que revisar una gran cantidad de recursos y repositorios por los que está distribuido el valor.
5. ¿Y ahora qué?
Una vez que hemos solucionado el problema real, que era la falla de seguridad que suponía tener expuestos los secretos en claro directamente en el repositorio, necesitamos replantear la forma en la que estamos sincronizando nuestros secretos. Los problemas derivados del nuevo enfoque, si bien no afectan a la seguridad, si que añaden una complejidad bastante importante de cara al mantenimiento y rotación de secretos.
Por ello, ahora ya sin urgencia, nos replanteamos el enfoque y necesitamos encontrar una solución que:
- Permita una gestión lo más centralizada posible de los secretos, con herramientas que no requieran un sistema operativo concreto.
- La gestión de los secretos debe ser realizada sólo por personal con un nivel de privilegios superior.
- Facilite una automatización lo más amplia posible de los procesos de creación y rotación de los secretos en el entorno productivo.
- No exponga los secretos ni siquiera cifrados en los repositorios para facilitar la validación del código publicado.
Continuará…
Versión en inglés publicada en el Blog de Xebia